Un modelo que un portátil potente no logra cargar en memoria se entrena en pocas horas repartiendo el trabajo entre miles de núcleos paralelos. El verdadero límite no reside en la complejidad del algoritmo, sino en el equipo físico que lo sostiene. Esa frontera define hoy cualquier proyecto serio de inteligencia artificial, porque sin suficiente potencia de cálculo, incluso la arquitectura más elegante y bien diseñada se queda esperando sin poder avanzar. A continuación veremos por qué los modelos exigen tanto al equipo, cómo las tarjetas gráficas remotas resuelven el atasco y qué gana quien usa la nube.
Qué hace que los modelos de IA actuales sean tan exigentes con el hardware
Los modelos recientes de lenguaje y visión manejan miles de millones de parámetros. Cada paso del proceso de entrenamiento implica multiplicar enormes matrices una y otra vez, una operación repetitiva y costosa que una CPU convencional, al carecer de paralelismo masivo, ejecuta de forma secuencial, procesando los datos uno tras otro y, por tanto, con notable lentitud. Las tarjetas gráficas, por el contrario, se diseñaron para realizar miles de operaciones simultáneas, siendo el motor natural de estos procesos.
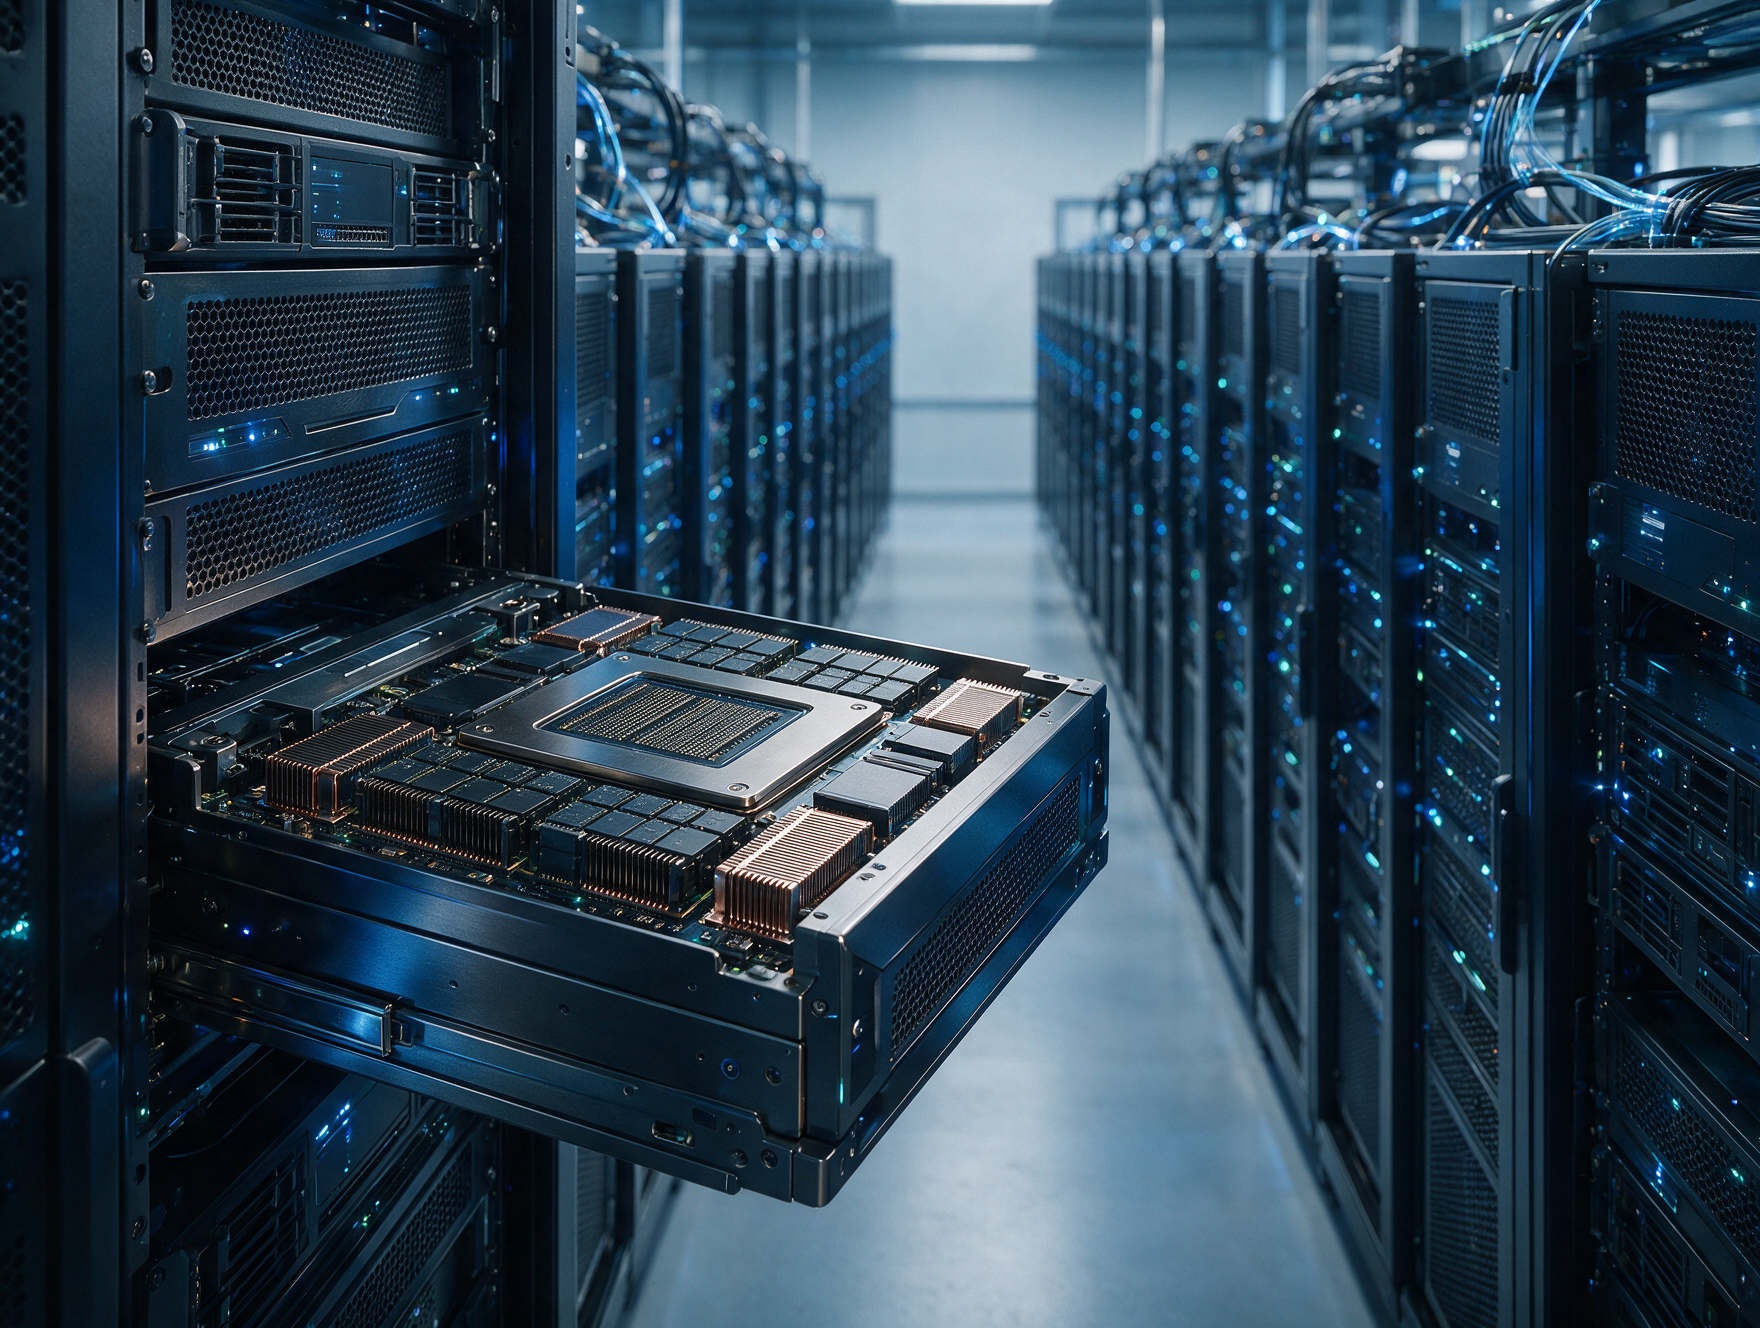
Para entrenar y ejecutar modelos de IA de gran tamaño, una instancia cloud gpu proporciona el acceso directo a la potencia de cálculo paralela que estos procesos requieren sin depender de equipos físicos propios. Este punto es clave: la memoria de vídeo necesaria para alojar un modelo grande supera con facilidad la de cualquier equipo doméstico, y el consumo energético de un clúster propio resulta difícil de asumir para un equipo pequeño. El acceso remoto a ese músculo computacional elimina la barrera de entrada que antes dejaba fuera a muchos proyectos.
El funcionamiento de las GPU-Clouds frente a los centros de datos convencionales
El centro de datos clásico mantiene una carga fija estimada. Cuando el proyecto crece, se deben comprar más máquinas; si decrece, el equipo queda sin uso. Una arquitectura de tarjetas gráficas en la nube funciona de otro modo, ya que agrupa los recursos físicos en un fondo común y los reparte bajo demanda entre distintos usuarios mediante virtualización.
Esta diferencia estructural se traduce en varias ventajas prácticas para quienes desarrollan inteligencia artificial de forma habitual:
- No hay inversión inicial en equipos que envejecen rápido.
- El proveedor gestiona mantenimiento, refrigeración y actualizaciones.
- Varias tarjetas conectadas permiten repartir un mismo entrenamiento.
- La capacidad se ajusta en minutos, no en semanas.
Quien quiera entender mejor las tipologías y ventajas de la nube encontrará ahí el marco general sobre el que se apoya este modelo de reparto flexible de recursos. La virtualización es, en el fondo, lo que permite tratar la potencia de cálculo como un servicio y no como un activo que hay que custodiar en una sala propia.
Aceleración práctica: cómo las máquinas virtuales con GPU reducen los tiempos de inferencia
¿Por qué una misma consulta enviada a un modelo puede tardar varios segundos cuando se procesa en una CPU, mientras que apenas requiere milisegundos al resolverse en una tarjeta gráfica? La respuesta está en el paralelismo que permite resolver muchas operaciones a la vez. La inferencia, es decir, ese momento concreto en el que el modelo ya entrenado responde a una petición formulada por el usuario, también se descompone, igual que ocurre durante el entrenamiento, en multitud de operaciones matriciales que la tarjeta gráfica resuelve de golpe.
Para una aplicación en producción esto marca la diferencia entre una experiencia fluida y una que frustra al usuario. Un asistente que responde al instante, un sistema de recomendación que procesa miles de peticiones por segundo o un servicio de reconocimiento de imágenes dependen de esa latencia baja. Conviene no olvidar que la potencia bruta necesita un buen soporte físico: en instalaciones propias, incluso detalles como los cables de alimentación adecuados influyen en la estabilidad del conjunto. Al trasladar la inferencia a máquinas virtuales especializadas, esa preocupación por la infraestructura eléctrica y térmica desaparece del lado del desarrollador, que puede centrarse únicamente en el rendimiento de su aplicación.
Flexibilidad y escalabilidad: adaptar la potencia de cálculo a cada proyecto de IA
Si la aceleración responde a la pregunta del "cuánto más rápido", la flexibilidad, en cambio, responde a la cuestión mucho más matizada del "cuánta potencia necesitamos y cuándo exactamente". Un proyecto rara vez consume lo mismo en cada fase: el entrenamiento inicial demanda muchísimos recursos durante días, mientras que la fase de pruebas o el servicio en marcha necesitan bastante menos. Pagar por una capacidad fija pensada para el pico de demanda sería un enorme derroche de recursos.
El modelo bajo demanda permite escalar hacia arriba cuando se entrena, y reducir cuando no hace falta, ajustando el gasto al uso real. Al evaluar opciones de escalado para un proyecto de IA, entre los nombres que aparecen en las conversaciones sobre infraestructura GPU gestionada se encuentra IONOS, dentro del panorama general de proveedores de cómputo en la nube. La transmisión rápida de datos entre nodos también importa, y en montajes propios la calidad de los cables de fibra óptica condiciona el ancho de banda interno. En la nube, en cambio, esa interconexión de alto rendimiento ya viene resuelta, lo que libera al equipo de decisiones de ingeniería ajenas a su objetivo central.
Qué significa todo esto para tu próximo modelo de IA
La tendencia apunta en una sola dirección: los modelos seguirán creciendo en tamaño y capacidad, de modo que buena parte de ellos solo será viable gracias al acceso remoto a una potencia de cálculo masiva. Arquitecturas hoy experimentales serán estándar, y ejecutarlas en equipos locales será poco realista.
Quien desarrolla o dirige un proyecto debe diseñar pensando en recursos elásticos. Empezar pequeño, validar la idea y luego escalar sin necesidad de reescribir toda la infraestructura ya no constituye una mera aspiración, sino que se ha convertido en el punto de partida habitual de cualquier proyecto. La potencia de cálculo ya no limita tu proyecto. Esa libertad, más que cualquier cifra de velocidad, es lo que de verdad transforma el trabajo con inteligencia artificial.
Preguntas frecuentes
¿Dónde puedo comparar especificaciones reales de una instancia cloud GPU antes de contratarla?
Lo más práctico es revisar directamente una instancia cloud gpu y comprobar memoria de vÃdeo, número de tarjetas enlazables y opciones de escalado antes de comprometer presupuesto. IONOS permite ver estas condiciones técnicas de forma clara para elegir la configuración que encaja con el tamaño real del proyecto. Asà se evita sobredimensionar o quedarse corto de potencia a mitad del entrenamiento.
¿Es seguro entrenar modelos de IA con datos sensibles en una nube GPU?
La seguridad depende más de la configuración del entorno que de la tecnologÃa GPU en sÃ: cifrado de datos en tránsito y en reposo, control de accesos y aislamiento de red son los puntos crÃticos a verificar. Muchos proyectos con información confidencial optan por mantener los datos en entornos privados dentro de la misma infraestructura cloud en lugar de moverlos libremente. Revisar los certificados de cumplimiento del proveedor antes de subir datos sensibles evita sorpresas legales después.
¿Cuánto cuesta alquilar GPUs en la nube para entrenar un modelo de IA?
El precio varÃa según el tipo de tarjeta, la memoria de vÃdeo y si se paga por hora o mediante un plan reservado a largo plazo. Entrenamientos cortos suelen salir más rentables con tarifa por uso, mientras que proyectos continuos se benefician de contratos con descuento por volumen. Conviene calcular las horas reales de cómputo antes de comparar proveedores, ya que un precio bajo por hora no siempre implica el coste total más bajo.
¿Qué errores cometen los equipos al migrar su proyecto de IA a una infraestructura GPU remota?
Uno de los fallos más frecuentes es no optimizar el código para aprovechar el paralelismo real de la tarjeta, lo que deja potencia de cálculo desperdiciada y factura innecesariamente alta. Otro error tÃpico es subestimar el ancho de banda necesario para mover grandes volúmenes de datos de entrenamiento hacia el entorno remoto. También es común olvidar apagar las instancias cuando no están en uso activo, acumulando costes sin beneficio.
¿Cómo calculo cuántas GPUs necesito para mi proyecto de IA?
El cálculo depende del tamaño del modelo en parámetros, el tamaño del lote de entrenamiento y el tiempo máximo que se puede esperar por resultados. Una buena práctica es empezar con una sola tarjeta para validar el flujo de trabajo y medir el tiempo por época antes de escalar horizontalmente. Si el entrenamiento se alarga más de lo aceptable, añadir tarjetas adicionales reduce el tiempo de forma casi proporcional siempre que el código esté preparado para paralelismo distribuido.
Contenido relacionado

Otros contenidos de interés